نوشتهها
Englishچرا حافظه مجازی برای یک سرویس بکاند مهم است؟
فضای آدرس، جدول صفحه و page fault و تفاوت RSS با VSZ: مدل حافظهای که پشت داشبوردهاست و توضیح میدهد چرا یک فرآیند وقتی میزبان آزاد به نظر میرسد کشته میشود.
یک کانتینر محدودیت ۵۱۲ مگابایتی دارد. فرآیند اصلی ۴۳۰ مگابایت RSS گزارش میکند، گره دهها گیگابایت حافظه آزاد دارد، و با این حال kernel فرآیند را میکشد. اعداد داشبورد دروغ نمیگویند، اما به سؤالی متفاوت از آنچه فکر میکنید پاسخ میدهند.
فضای آدرس یک نقشه است
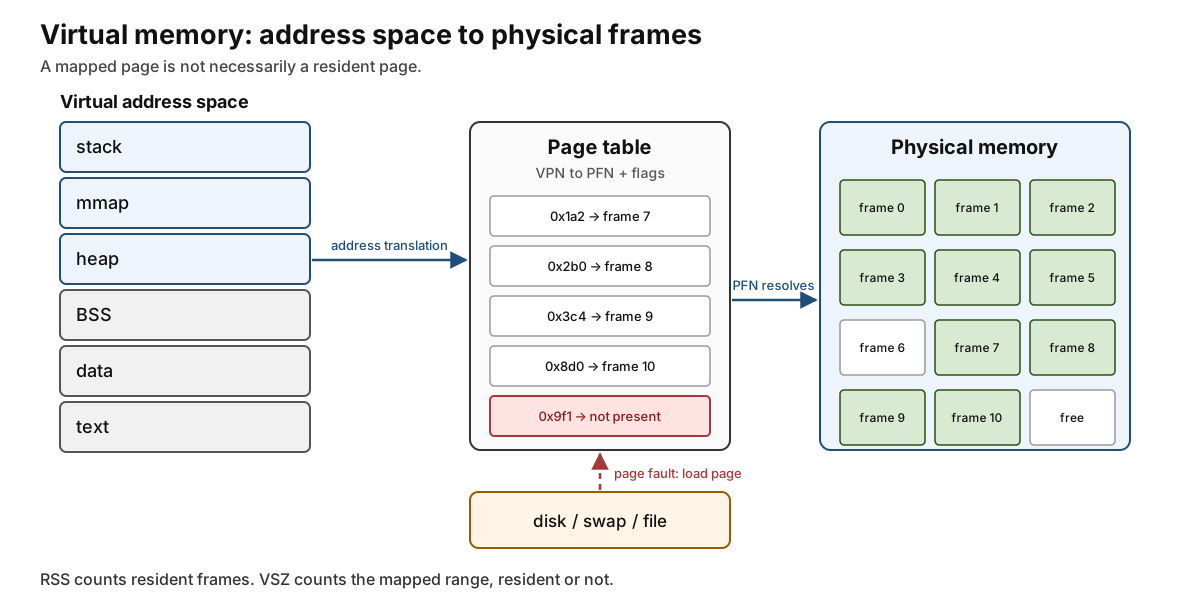
فرآیند یک بلوک پیوسته از حافظه فیزیکی نمیگیرد. یک فضای آدرس مجازی میگیرد و kernel ترجمه صفحه مجازی به قاب فیزیکی را نگه میدارد. چیدمان آشناست: text برای کد، data برای متغیرهای global مقدارگرفته، BSS برای globalهای صفرشده، heap که با تخصیص رشد میکند، ناحیه mmap برای کتابخانههای مشترک و فایلها و تخصیصهای بزرگ، و یک stack برای هر thread.
جدول صفحه و TLB
روی x86-64 ترجمه از یک جدول صفحه چندسطحی عبور میکند و هر سطح با بخشی از آدرس مجازی ایندکس میشود. برگ درخت شماره قاب فیزیکی و پرچمهایی مثل present و writable و executable را نگه میدارد. طی کردن چند سطح چند دسترسی به حافظه هزینه دارد، بنابراین CPU ترجمههای اخیر را در TLB کش میکند. TLB miss مثل page fault نیست، اما رایگان هم نیست؛ کدهایی با اشارهگر زیاد و locality ضعیف هزینه هر دو را میپردازند.
page faultها عادیاند
page fault وقتی رخ میدهد که CPU نتواند ترجمه را پیدا کند. fault جزئی یعنی صفحه در حافظه هست ولی نگاشت یا دسترسیها باید اصلاح شوند، مثل copy-on-write بعد از fork. fault اصلی یعنی صفحه باید از دیسک یا swap خوانده شود. demand paging باعث میشود صفحه تازهتخصیصیافته تا اولین نوشتن پشتوانه فیزیکی نداشته باشد؛ پس یک تخصیص بزرگ میتواند موفق شود و بعد صفحهبهصفحه هنگام لمس fault بدهد.
| معیار | چه چیزی را میشمارد | کجا گمراه میکند |
|---|---|---|
| VSZ | اندازه مجازی همه نگاشتها | صفحههای رزروشده و لمسنشده را هم شامل میشود |
| RSS | صفحههای مقیم در حافظه فیزیکی | کتابخانههای مشترک را بین فرآیندها دوباره میشمارد |
| PSS | RSS با تقسیم صفحههای مشترک | جمعآوری کندتر و کمتر آشناست |
| page cache | صفحههای فایلی که kernel کش کرده | بخشی از RSS فرآیند نیست |
mmap و malloc و OOM killer
malloc همیشه حافظه را از heap برنمیگرداند. glibc تخصیصهای کوچک را از arenaها میدهد و برای تخصیصهای بزرگتر از یک آستانه پویا از mmap استفاده میکند. نگاشت فایلی اجازه میدهد page cache و فرآیند صفحهها را شریک شوند؛ نگاشت anonymous پشت heap و stackهاست. MADV_DONTNEED به kernel میگوید صفحهها را میتواند دور بریزد، و MADV_FREE در پس گرفتن آنها تنبلتر است. transparent huge page هزینه fault و TLB را کم میکند، اما میتواند ردپای حافظه و tail latency را هنگام compaction بالا ببرد.
OOM killer آخرین راه kernel است وقتی reclaim نمیتواند یک تخصیص را برآورده کند. زیر محدودیت cgroup قربانی را داخل همان گروه انتخاب میکند. فرآیند میتواند به خاطر لمس حافظهای که مدتها قبل نگاشت کرده کشته شود؛ به همین دلیل یک نشتی کند ممکن است بعد از دیپلویی که الگوی ترافیک را عوض کرده، مثل مرگ ناگهانی به نظر برسد.
#define _GNU_SOURCE
#include <stddef.h>
#include <sys/mman.h>
int main(void) {
size_t len = 64UL * 1024 * 1024;
char *p = mmap(NULL, len, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
if (p == MAP_FAILED) return 1;
for (size_t i = 0; i < len; i += 4096) {
p[i] = 1; /* اولین نوشتن یک صفحه ۴ کیلوبایتی را fault میکند */
}
munmap(p, len);
return 0;
}grep -E 'Vm(Size|RSS|Swap)' /proc/$PID/status
cat /sys/fs/cgroup/memory.max
cat /sys/fs/cgroup/memory.currentزیر بار چه تغییری میکند
حافظه پیش از آنکه به مشکل OOM تبدیل شود، به مشکل تأخیر تبدیل میشود. فرآیندی که مدام صفحهها را fault میکند بر سر پهنای باند با page cache و سایر tenantها رقابت میکند. allocatorهایی که حافظه آزادشده را نگه میدارند RSS را بالا نگه میدارند حتی وقتی مجموعه زنده برنامه کوچک است. زیر محدودیت cgroup، اسکن reclaim میتواند تخصیصها را کند کند بدون اینکه خطایی رخ دهد؛ پس p99 بالا میرود در حالی که مصرف CPU عادی به نظر میرسد.
چه چیزی را با خود ببریم
VSZ و RSS و PSS و مصرف cgroup را چهار اندازهگیری متفاوت بدانید. پیش از هر تنظیمی فضای آدرس را نقشه کنید: کدام ناحیه فایلی است، کدام anonymous است و کدام با هر درخواست رشد میکند. بعد درمانی انتخاب کنید که با الگوی fault سازگار باشد: تخصیص کمتر، cache محدود، یا سیاست madvise آگاهانه. huge page و پرچمهای MADV_* تنظیماتی با هزینه و فایدهاند، نه پیشفرضهایی که از یک پست بنچمارک کپی شوند.